IA et conseil d'arrosage
| Niveau | Intermédiaire (un peu de Python) |
|---|---|
| Matériel | Un capteur d'humidité du sol, une carte LoRaWAN ou ESP32, un ordinateur |
| Coût | Outils gratuits ; capteur et carte : voir Matériel et coûts |
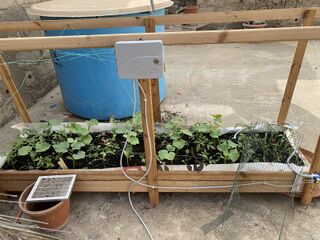
Le conseil d'arrosage répond à une question simple : « dois-je arroser demain, et de combien ? ». On peut y répondre par une règle fixe, puis, avec assez de données, par un modèle qui apprend la réponse. Cette page montre le chemin, avec un exemple générique ; elle prolonge le cas pratique d'arrosage d'un potager sur terrasse.
Niveau 1 : la règle à seuil[modifier | modifier le wikicode]
« Si l'humidité du sol à 15 cm est inférieure à un seuil, on arrose jusqu'à un niveau cible. » C'est simple, lisible, et souvent suffisant. Le seuil dépend du sol et de la culture : voir Besoins en eau par culture et Irrigation. Les besoins en eau d'une culture se calculent aussi à partir de l'évapotranspiration, méthode décrite par la FAO[1]. Ses limites : le seuil est le même quelle que soit la météo du lendemain.
Niveau 2 : la règle qui regarde la météo[modifier | modifier le wikicode]
On y ajoute la pluie prévue (voir IA et météo) : inutile d'arroser si de la pluie est attendue. Toujours sans apprentissage.
Niveau 3 : un modèle appris[modifier | modifier le wikicode]
Ici, on entraîne un modèle sur l'historique : « d'après l'humidité d'aujourd'hui, la température, le vent et la pluie prévue, quelle sera l'humidité demain ? ». On en déduit s'il faut arroser. Deux modèles simples avec scikit-learn : la régression linéaire (prédit une valeur) et l'arbre de décision (suite de questions oui/non, facile à lire)[2].
Ce qu'il faut mesurer pendant une saison[modifier | modifier le wikicode]
| Mesure | Fréquence | Pourquoi |
|---|---|---|
| Humidité du sol (une ou deux profondeurs) | 15 à 30 min | la grandeur à prédire |
| Température et humidité de l'air | 15 à 30 min | elles pilotent l'évaporation |
| Pluie, vent | horaire | venue de la station ou d'une source ouverte |
| Quantité d'eau apportée (volume ou durée de pompe) | à chaque arrosage | sans elle, le modèle ne comprend pas les remontées d'humidité |
| Culture, stade, date de semis | à chaque changement | une tomate en fleur n'a pas les besoins d'un semis |
Au moins une saison complète est nécessaire ; avec trop peu de données, un modèle appris fait pire qu'une règle à seuil. Respectez le temps d'antenne LoRaWAN (voir LoRa et LoRaWAN).
Exemple pas à pas (données fictives)[modifier | modifier le wikicode]
Le fichier mesures.csv contient une ligne par jour : humidite_sol (%), temperature_max (°C), pluie_mm, arrosage_l (litres), et humidite_demain (%), la valeur à prédire.
# Exemple générique : prédire l'humidité du sol de demain, puis décider d'arroser.
# Prérequis : pip install pandas scikit-learn
import pandas as pd
from sklearn.tree import DecisionTreeRegressor
from sklearn.metrics import mean_absolute_error

# 1. Lire les données (une ligne par jour)
donnees = pd.read_csv("mesures.csv")
variables = ["humidite_sol", "temperature_max", "pluie_mm", "arrosage_l"]
X = donnees[variables]          # ce que l'on connaît aujourd'hui
y = donnees["humidite_demain"]  # ce que l'on veut prévoir

# 2. Séparer dans le temps : on apprend sur le début de la saison, on teste sur la fin
coupure = int(len(donnees) * 0.8)
X_app, X_test = X.iloc[:coupure], X.iloc[coupure:]
y_app, y_test = y.iloc[:coupure], y.iloc[coupure:]

# 3. Entraîner un arbre peu profond (profondeur limitée = moins de surapprentissage)
modele = DecisionTreeRegressor(max_depth=4, random_state=0)
modele.fit(X_app, y_app)

# 4. Mesurer l'erreur moyenne sur les jours que le modèle n'a jamais vus
erreur = mean_absolute_error(y_test, modele.predict(X_test))
print("Erreur moyenne :", round(erreur, 1), "points d'humidité")

# 5. Comparer à la solution la plus bête : « demain = aujourd'hui »
bete = mean_absolute_error(y_test, X_test["humidite_sol"])
print("Erreur de la règle « demain = aujourd'hui » :", round(bete, 1))

# 6. Décider : arroser si l'humidité prévue passe sous le seuil de la culture
SEUIL = 22.0   # à remplacer par le seuil mesuré pour votre sol et votre culture
aujourdhui = pd.DataFrame([[24.0, 36.0, 0.0, 0.0]], columns=variables)  # valeurs fictives
prevue = modele.predict(aujourdhui)[0]
print("Arroser demain" if prevue < SEUIL else "Pas besoin d'arroser", "(humidité prévue :", round(prevue, 1), "%)")
La comparaison de l'étape 5 est essentielle : si le modèle ne bat pas la règle la plus simple, ne l'utilisez pas. Le choix d'un découpage dans le temps (et non au hasard) évite de tester sur des jours voisins de ceux appris. Pour aller plus loin : validation croisée adaptée aux séries temporelles et forêt d'arbres (RandomForestRegressor)[3].
Pièges[modifier | modifier le wikicode]
- Capteur dérivant ou mal étalonné : le modèle apprend ses erreurs.
- Changement de culture ou de sol : le modèle n'est plus valable.
- Pompe en panne : une humidité qui ne remonte pas peut venir du matériel, pas du modèle. Gardez une règle de sécurité (durée maximale d'arrosage).
- Pas de décision automatique sans plafond d'eau et sans possibilité de reprise manuelle.
Voir aussi[modifier | modifier le wikicode]